谷歌云Pathways分布式机器学习运行时正式商用:过去90天已消耗逾1.3亿TPU芯片小时
谷歌云于11月9日宣布,源自DeepMind、用于训练和推理前沿模型的分布式机器学习运行时Cloud Pathways,已在Google Kubernetes Engine上正式商用。官方称过去90天已有领先AI公司与企业通过GKE上的Pathways消耗超过1.3亿Cloud TPU芯片小时。该运行时支持TPU v5e、v5p、Trillium(v6e)与Ironwood(7x),并在Cluster Director的Slurm集群上提供预览。
导读
2026年11月9日,谷歌云宣布 Cloud Pathways(云上的Pathways)在 Google Kubernetes Engine(GKE) 上正式商用(GA),成为Google Cloud AI Hypercomputer的核心运行时支柱之一。
Pathways最初由Google DeepMind设计,用于训练和推理包括Gemini在内的谷歌前沿模型,是面向大规模、异构加速器集群的分布式机器学习运行时。官方称,仅在过去90天,已有领先AI公司与全球企业使用GKE上的Pathways,在多代TPU上消耗了超过 1.3亿 Cloud TPU芯片小时。随着正式商用,所有谷歌云客户都可以使用同一套单控制器运行时、同机部署的Python sidecar,以及支撑谷歌最大规模AI负载的弹性容错能力。同时,Pathways与 Cluster Director 的集成进入预览,可扩展到Slurm集群,支持统一的多slice JAX执行、弹性训练和交互式笔记本。
要解决的问题和核心架构
官方认为,当AI负载扩展到数千个加速器,覆盖多slice预训练、分离式推理和多程序强化学习循环时,传统多控制器方案更难编程和管理。在默认的多控制器JAX中,每个TPU主机运行各自的Python解释器,只看到本地连接的设备,并以锁步方式执行同一套SPMD程序,这让异构MPMD工作流和跨slice的资源管理变得复杂、脆弱。
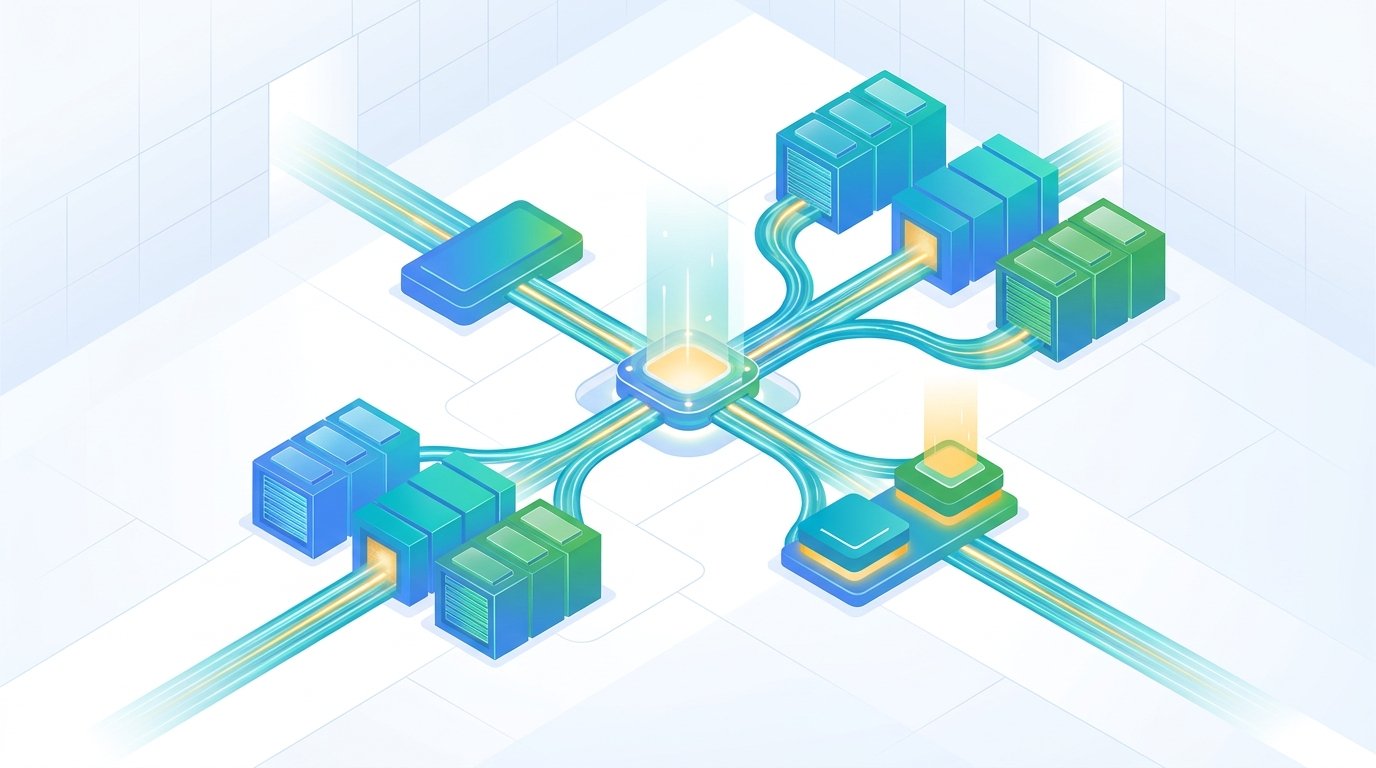
Cloud Pathways用基于开源 Interim Framework Runtime(IFRT) 的统一单控制器架构替换多控制器管理。通过设置 `JAX_PLATFORMS=proxy` 并使用 `pathwaysutils`,一个JAX客户端进程可以查看并编排多个大型TPU slice,把数千个TPU芯片看作仿佛都连在本地。
被列出的核心能力包括:
- 单控制器编排:由单一控制器管理图求值、持久化的Cloud Storage编译缓存,以及跨TPU slice的异步XLA HLO分发
- 同机Python sidecar:客户端侧的同机Python sidecar容器(支持共享内存)可直接在TPU主机上运行分布式数据加载和检查点等计算密集的Python逻辑
- 有弹性的容错训练:用`pathwaysutils`做弹性训练,借助主机内存快照,在硬件故障时把训练动态重分片到N-1个slice,而不让客户端崩溃,从而把作业存活与单个slice中断解耦
- 交互模式与共享Pathways服务:可从笔记本或终端以交互方式运行、检查和调试JAX负载,或用Shared Pathways Service在多个用户与作业之间按需共享一组长期运行的Cloud TPU slice
客户案例与可用性
官方称,前沿AI实验室、量化研究机构与全球消费平台已在GKE上用Cloud Pathways跑生产负载。其中一个例子是:某全球大型消费科技公司在数万个TPU v5p、Trillium(v6e)和Ironwood(TPU 7x)芯片上,用Cloud Pathways跑生产级批量与强化学习推理,每季度消耗超过 1亿 芯片小时,并与谷歌共同设计弹性原语以扩展到预训练。
另一个具名案例是ZenteiQ:该公司使用Cloud Pathways on GKE,配合Cluster Toolkit(`gcluster`)、同机Python sidecar和主机快照,在多slice Trillium(v6e)集群上为科学基础模型做弹性预训练(MaxText)以及单控制器强化学习(MaxText + Tunix)。创始人Sashikumaar Ganesan教授表示,控制器会监视TPU拓扑,并在芯片或slice离线时动态重新组网和调整负载规模;再结合主机快照,可把中断后的恢复时间压到较低水平,让可用TPU容量保持充分利用。
Cloud Pathways即日起在所有支持Cloud TPU v5e、v5p、Trillium(v6e) 和 Ironwood(TPU 7x) 的谷歌云区域、于GKE上正式可用,版本化容器镜像位于 `us-docker.pkg.dev/cloud-tpu-v2-images/cloud-pathways`,支持JAX 0.10.1+。在Cluster Director的Slurm TPU集群上则为预览。文档覆盖GKE与Slurm的集群创建、批量负载、交互笔记本、弹性训练、多主机推理、JAX负载迁移与故障排查。
来源
Google Cloud Blog 2026-11-09,Shaurya Gupta与Monica Song,Cloud Pathways, a distributed ML runtime for massive accelerator fleets, now GA。芯片小时与客户引用均来自该公告。