英伟达发布车载推理模型Alpamayo 2 Edge:20亿参数,Thor上车端到端时延160–190毫秒
英伟达于11月10日发布面向车载实时推理的Alpamayo 2 Edge:约20亿参数的自适应视觉-语言-动作模型,可在DRIVE AGX Thor上运行。模型仅在需要时生成因果链推理,并配扩散动作专家输出轨迹。闭环强化学习使驾驶表现较未做闭环RL的最佳检查点提升48.9%;参考部署配方在Thor上测得像素到轨迹时延160–190毫秒。权重已在Hugging Face开放。
导读
2026年11月10日,英伟达技术博客由自主系统与物理AI研究副总裁Marco Pavone与Boris Ivanovic撰文,介绍面向车载计算与时延约束的推理模型 NVIDIA Alpamayo 2 Edge。这是一个约 20亿参数 的自适应推理视觉-语言-动作(VLA)模型,为在 NVIDIA DRIVE AGX Thor 上实时运行而设计。
模型以基于Nemotron、同为20亿参数的 Cosmos 3 Edge 推理骨干为基础,再配上扩散动作专家(diffusion action expert),利用环视相机观测、时间上下文与导航输入,生成 Chain-of-Causation(CoC,因果链) 推理和未来行驶轨迹。它会自适应地推理:只在需要时生成推理文本,日常行驶中减少不必要的token生成,从而节省推理算力。
训练、评测与合作伙伴反馈
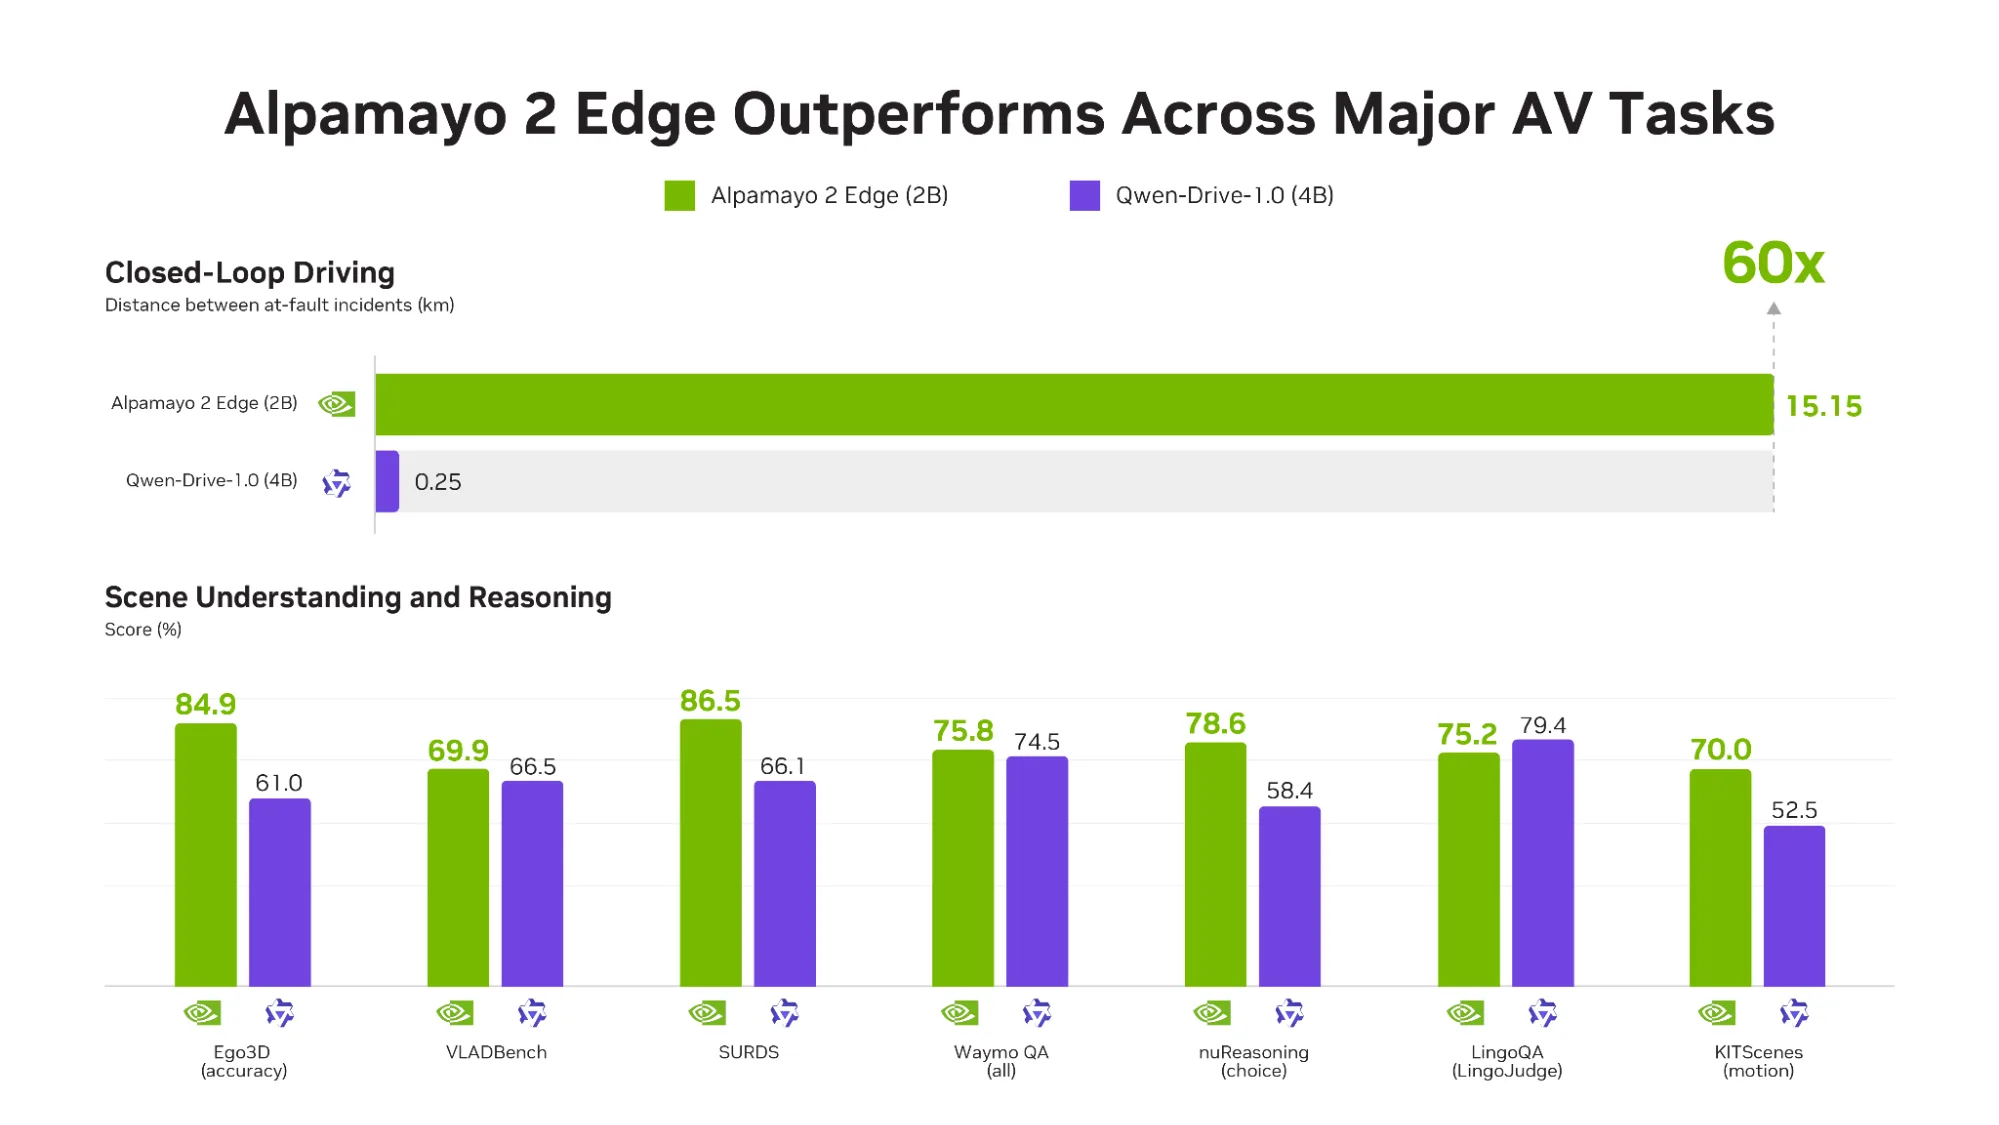
Alpamayo 2 Edge在 NVIDIA AlpaGym 中经过闭环强化学习后训练。官方称,在未做闭环强化学习的最佳检查点之上,闭环驾驶表现再提升 48.9%。博客配图还把Alpamayo 2 Edge(20亿参数)与 Qwen-Drive-1.0(40亿参数)在闭环驾驶、开环轨迹预测以及场景理解与推理上做了对比,并特别写道:Alpamayo 2 Edge在AlpaSim中,责任事故之间的行驶距离约为对比模型的约 60倍。这些数字来自英伟达公布的评测,需结合具体基准与复现条件看待。
早期合作伙伴反馈(均为对方转述,属个例测试)包括:
- PORT首席技术官Matas Simonavicius:拿到早期权限后数天内,就在自家伦敦街景的NuRec重建中做了闭环测试。早期仿真里,Edge保持车道的次数是Alpamayo 1.5的两倍以上,从车道偏移中恢复约多40%,并且在同一块GPU上,开箱规划速度大约是他们手工调优的Alpamayo 1.5服务器的两倍。
- Niulinx联合创始人兼运动规划负责人Luca Crotti:在零样本评估中,尽管传感器配置差异很大,Alpamayo 2 Edge相对Alpamayo 2 Super把位移误差(minADE)降低 13.6%、3秒横向预测误差(RMSE)降低 46.1%;用自有驾驶数据微调后,位移误差较Edge基线再降 44.2%。从拿到模型到在实车上跑通第一次测试只用了几天。
- Embedl首席执行官兼联合创始人Hans Salomonsson:不到48小时,就让Alpamayo 2 Edge在AGX Thor上以 10 Hz 运行,用于实时规划。
部署优化与时延
从Hugging Face下载时,默认权重为BF16,可直接作为PyTorch模型在受支持的英伟达GPU上运行。要在DRIVE AGX Thor上达到实时,还需进一步做推理优化。Alpamayo Developer Hub提供了针对Thor的部署配方:准备Alpamayo 2 Edge检查点与 DFlash2 起草器、校准FP8尺度、导出ONNX、用TensorRT Edge-LLM插件构建TensorRT引擎,再运行Python测试套件。参考配置在 DRIVE AGX Thor-X 上测得,软件栈为DRIVE OS 7.2.7.0、CUDA 13.4、TensorRT 11.3.1.9。
按该配方优化后,官方测得 像素到轨迹 的推理时延为 160毫秒至190毫秒,随推理文本多少而变化。同一套检查还会把优化后模型的输出,与使用相同输入和种子动作噪声的BF16 PyTorch参考结果做对比。
模型的其他设计要点还包括:用Alpamayo 2 Super生成的CoC推理自动标注做离线蒸馏;在线用多分辨率输入编码环视观测;用DFlash2做推测解码以加快在线推理;以及面向TensorRT与TensorRT-Edge-LLM的量化与加速配方。推理时,模型有时会输出特殊token而非推理轨迹,表示当前属于日常行驶、以节省算力。
AlpaJudge:用评测闭环改进推理
为在缩小模型的同时保住推理与驾驶质量,英伟达把人类校准的评测与奖励模型 AlpaJudge 用于Alpamayo 2 Edge的开发,用来评估推理轨迹、筛选更高价值的训练数据,并为强化学习提供奖励。AlpaJudge有两个检查点变体:
- AlpaJudge-RB(有参考):输入问题、参考答案与候选答案,不需要图像,输出0到1的对齐概率
- AlpaJudge-RF(无参考):输入三帧前向广角、三帧前向长焦、自车元动作历史与未来,以及候选理由,输出五项分项概率以及动作、组件和总分
RF的计分定义为:action = p_match × (1 + p_safe)/2,component为p_grounded、p_complete、p_causal的均值,overall = 0.6×action + 0.4×component。示例笔记本在固定施工区样本上的冒烟测试中,报告RB对齐度为 0.999、RF总分为 0.842。博客还给出了把AlpaJudge用于训练样本筛选,以及作为开环GRPO训练中推理奖励的公开RL配方用法。
Alpamayo 2 Edge与AlpaJudge均可在Hugging Face获取,仓库包括 `nvidia/Alpamayo2-Edge` 与 `nvidia/alpajudge`。
来源
NVIDIA Technical Blog 2026-11-10,Marco Pavone与Boris Ivanovic,Running AV Reasoning Models Within Onboard Compute and Latency Limits。文中提升幅度、时延与合作伙伴数据均来自该博文及转述,部分为早期或个例测试。